Des feuilles de temps scannées à la base métier : le pipeline IA, étape par étape
Des centaines de feuilles de temps scannées, saisies à la main, sans contrôle. Voici le pipeline IA que j'ai conçu pour un acteur industriel, de l'arrivée du scan à l'écriture en base.
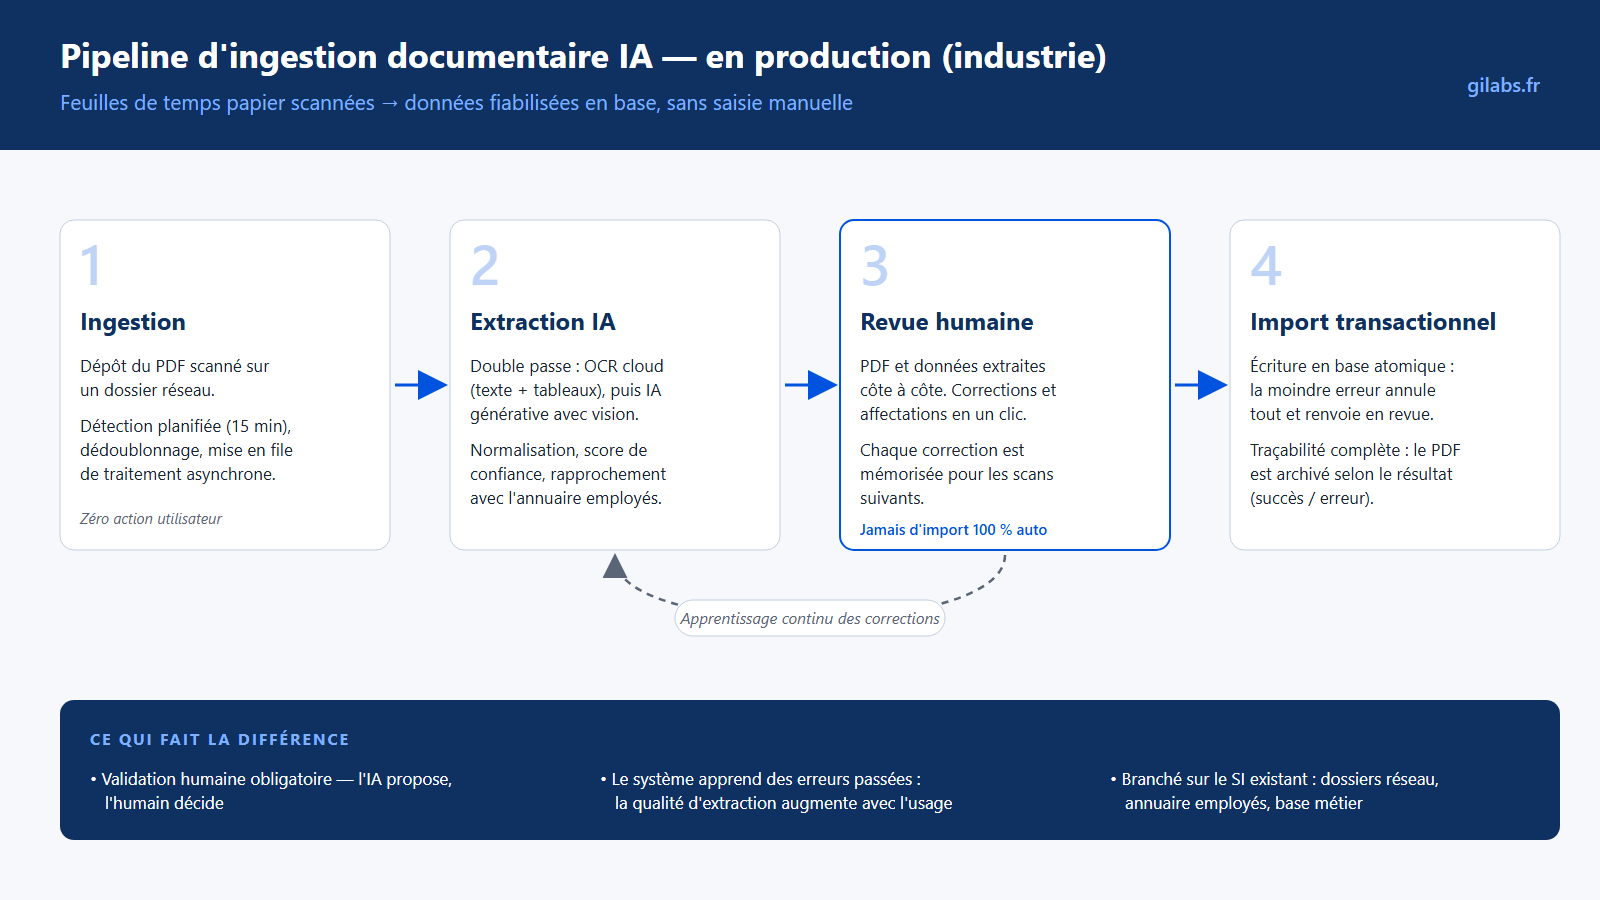
Des centaines de feuilles de temps papier scannées chaque mois. Saisie manuelle, erreurs de report, aucun contrôle systématique. C’est le point de départ d’un projet mené pour un acteur industriel international, et le pipeline d’extraction documentaire que j’ai conçu et mis en production répond à un problème très concret : transformer un document scanné en donnée fiable dans un système métier, sans faire disparaître le contrôle humain là où il compte.
Le pipeline, en quatre étapes
Ingestion automatique. Les PDF scannés déposés sur un dossier réseau partent seuls en file de traitement. Aucune action utilisateur n’est nécessaire pour déclencher le traitement.
Extraction en double passe. Une première passe d’OCR cloud récupère le texte et les tableaux. Une seconde passe, avec un modèle d’IA générative capable de vision, vient fiabiliser cette extraction : normalisation des champs, score de confiance par donnée extraite, rapprochement automatique avec l’annuaire des employés.
Revue humaine systématique. Une interface de validation présente le PDF source et les données extraites côte à côte. Il n’y a jamais d’import à 100 % automatique : chaque lot passe par un opérateur qui confirme ou corrige.
Import transactionnel. L’écriture en base se fait de façon atomique, avec un rollback complet à la moindre erreur, et une traçabilité complète de chaque document traité.
Ce qui compte vraiment n’est pas le modèle
Ce qui fait tenir ce système en production, ce n’est pas le choix du modèle d’IA. Ce sont des décisions d’ingénierie : la validation humaine obligatoire, les corrections des opérateurs réinjectées dans les extractions suivantes, et des moteurs d’extraction qu’on remplace sans toucher au reste. Je les détaille, avec ce qu’elles changent pour un dirigeant, dans ce qui fait tenir un pipeline documentaire en production.
Un système, pas un POC
Ce n’est pas un prototype qui tourne en démo. C’est un système intégré au système d’information existant (dossiers réseau, annuaire, base métier) et utilisé tous les jours. C’est exactement le pattern que je retrouve dans la plupart des projets d’intégration IA qui tiennent dans la durée : une couche IA qui propose, une couche déterministe qui valide, un humain qui tranche sur les cas ambigus. Je détaille ce pattern d’architecture dans l’IA propose, le déterministe dispose. Le contexte, les contraintes et le résultat du projet sont décrits dans la réalisation « pipeline documentaire IA ».
Ma conviction, confirmée projet après projet : l’IA qui crée de la valeur en entreprise est celle qu’on branche sur l’existant, avec l’humain dans la boucle au bon endroit, pas celle qu’on pose à côté du système en espérant qu’elle remplace le contrôle.